▲ 총괄 코디네이터가 초경량 서브에이전트 군집에 미세 태스크를 병렬 위임하여 98% 비용 절감을 실현하는 지능형 오케스트레이션 허브
생성형 AI를 업무 파이프라인에 본격 도입한 기업과 파워 유저들이 마주하는 가장 잔인한 장벽은 바로 '비용 폭탄'과 '사용량 제한(Rate Limit)'입니다. 최상위 프론티어 모델(Claude Opus, GPT-4o 등)에 20만 토큰에 달하는 방대한 사내 문서를 통째로 밀어 넣고 대화를 몇 번 나누다 보면, 한 달 API 비용이 수백만 원을 훌쩍 넘거나 '주간 사용량 한도에 도달했습니다'라는 경고창을 마주하게 됩니다.
하지만 최근 글로벌 AI 개발자 커뮤니티에서는 정반대의 현상이 일어나고 있습니다. 월 수천 달러를 쓰던 팀들이 단 하나의 아키텍처 전환만으로 비용을 98% 삭감하면서도 처리 속도는 5배 끌어올리는 기적을 만들어내고 있습니다. 그 핵심 비결이 바로 '초경량 서브에이전트 위임 설계(Subagent Delegation)'입니다.
단일 거대 모델의 함정: 200k 토큰 공룡은 왜 비효율적인가?
많은 사용자가 저지르는 가장 흔한 실수는 비싼 최상위 모델 하나만을 켜두고 모든 작업을 단일 대화창 안에서 끝내려 하는 '모놀리식(Monolithic)' 방식입니다:
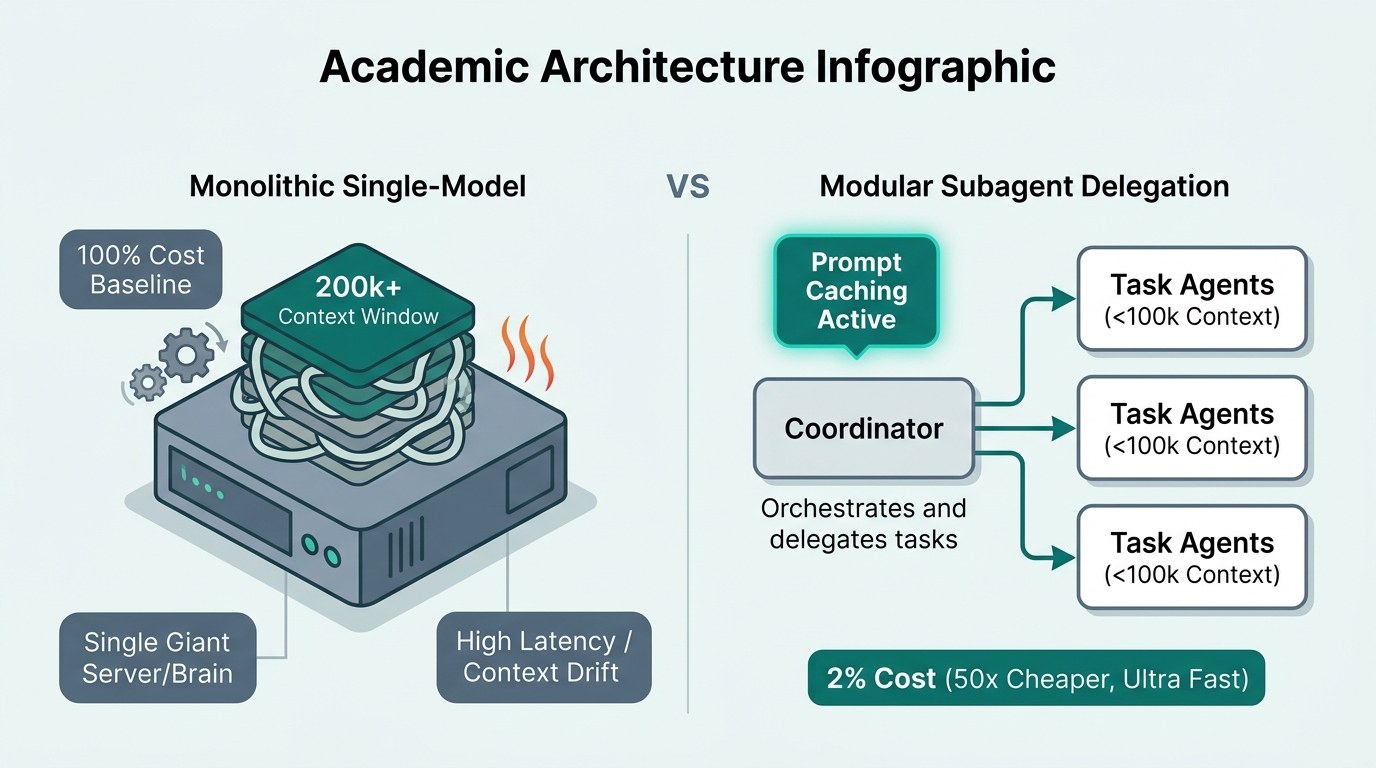
▲ 거대 컨텍스트로 둔중해진 단일 공룡 모델(좌측 100% 비용) vs 100k 미만 경량 모델로 분산 처리하는 서브에이전트 프레임워크(우측 2% 비용)
- 누적 토큰의 복리 비용 폭탄: 대화창에 10만 토큰의 문서가 들어있을 때, 사용자가 "이 부분 오타 고쳐줘"라는 한 줄(10토큰)을 질문하면 시스템은 매 질문마다 이전의 10만 토큰 전체를 다시 읽어 들이며 비용을 과금합니다.
- 주의력 저하(Lost in the Middle): 컨텍스트가 15만, 20만 토큰으로 부풀어 오르면 LLM의 주의 집중도가 희석되어 문서 중간에 적힌 핵심 사실을 망각하거나 엉뚱한 환각을 일으킵니다.
- 과도한 오버스펙(Overkill): 단순한 데이터 포맷 변환, JSON 파싱, 정규표현식 추출 같은 기본 작업에 비싼 최상위 추론 모델을 사용하는 것은, 동네 편의점에 가기 위해 대형 덤프트럭을 몰고 나가는 것과 같습니다.
프론티어 모델 vs 초경량 특화 모델 경제성 매트릭스
놀랍게도 오늘날 최신 초경량 모델(예: Claude Haiku 5.5)은 불과 6개월 전 SOTA(최고 성능)였던 플래그십 모델(Opus 4.6)을 뛰어넘는 추론 지능을 지니고 있습니다. 반면 비용은 1/50 수준에 불과합니다:
| 평가 지표 | 프론티어 대형 모델 (Opus급) | 초경량 고속 모델 (Haiku급) |
|---|---|---|
| 100만 토큰당 입력 비용 | \$15.00 ~ \$20.00 (기준 100%) | \$0.25 ~ \$0.40 (약 2% 수준) |
| 첫 토큰 출력 속도 (TTFT) | 2.5초 ~ 5초 (심층 사고 지연) | 0.2초 ~ 0.5초 (초고속 반응) |
| 최적 권장 컨텍스트 크기 | 전체 아키텍처 기획, 종합 검토 | 100k 토큰 미만의 정밀 마이크로 작업 |
| 이상적인 조직 내 역할 | 총괄 기획 총괄 아키텍트 (1명) | 현장 특화 실무 실행 서브에이전트 (수십 명) |
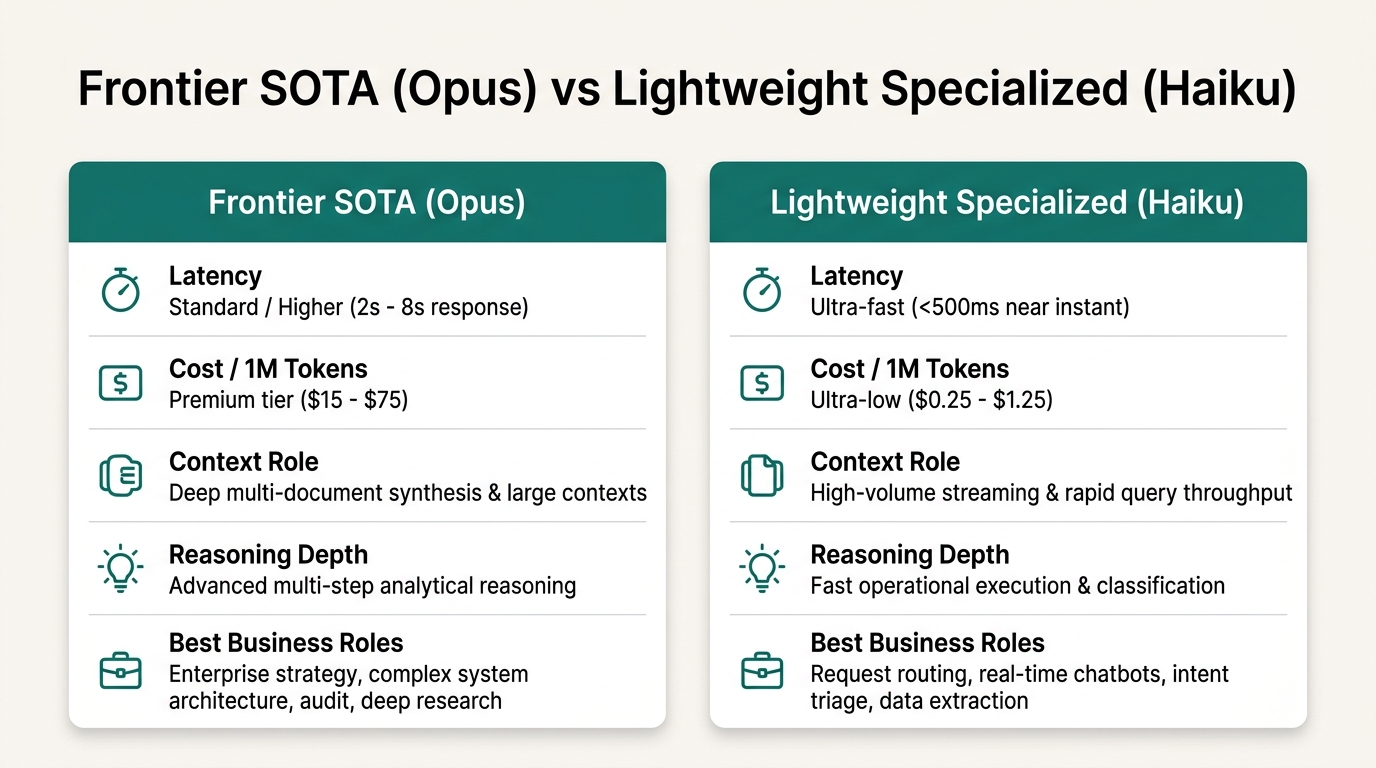
▲ 레이턴시, 백만 토큰당 단가, 추론 깊이 및 최적 비즈니스 배치 영역을 분석한 비교 매트릭스
98% 절감을 실현하는 4단계 토큰 제어 라이프사이클
진정한 AI 파워 유저들은 토큰 한도에 부딪히기 전에 시스템 단에서 토큰을 실시간 감시하고 작업을 위임하는 '토큰 임계치 훅(Hook)' 메커니즘을 가동합니다:
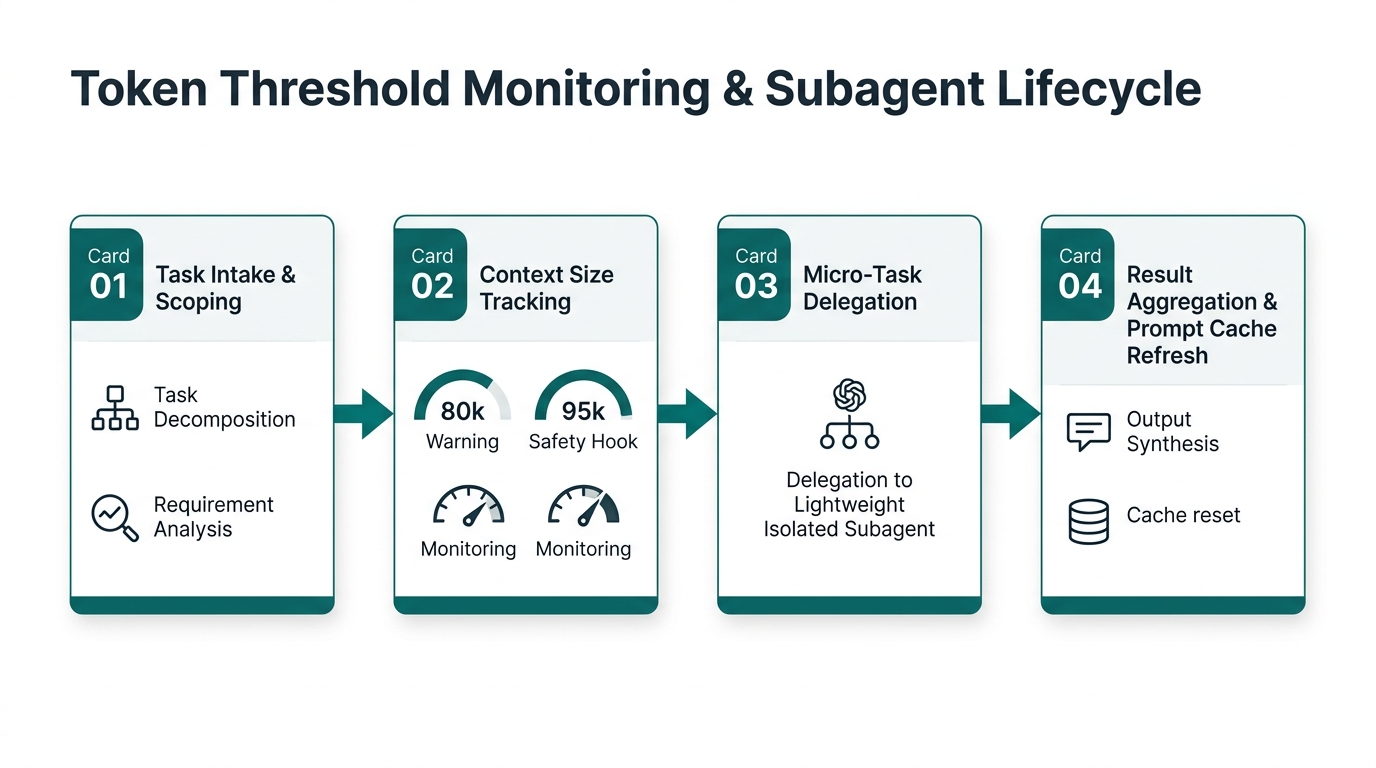
▲ 목표 수립에서 80k/95k 안전 훅 감지, 서브에이전트 오프로딩 및 캐시 리프레시로 이어지는 4단계 제어 흐름
- 1. 작업 분해 (Task Scoping): 상위 오케스트레이터(Opus급)는 직접 코드를 짜거나 문서를 수십 장 쓰지 않습니다. 전체 과업을 '100k 토큰 미만으로 완료 가능한 독립 단위'로 정교하게 분해합니다.
- 2. 80k / 95k 토큰 안전 훅 (Safety Hooks): 서브에이전트의 컨텍스트 사용량이 8만 토큰에 도달하면 경고를 띄우고, 9.5만 토큰에 도달하면 자동으로 현재까지의 산출물을 요약하여 저장한 뒤 세션을 리셋합니다.
- 3. 프롬프트 캐싱(Prompt Caching) 극대화: 서브에이전트들이 공통으로 참조하는 사내 가이드라인이나 API 스펙 문서는 캐시 헤더를 지정하여 90% 이상 할인된 캐시 읽기 비용으로 재활용합니다.
- 4. 결과 취합 및 팩트 검증: 가벼운 서브에이전트들이 병렬로 끝마친 결과물만을 메인 오케스트레이터가 받아 최종 정합성을 검토하고 브리핑을 완성합니다.
비개발자를 위한 서브에이전트 오케스트레이션 의사코드(Pseudocode)
복잡한 프로그래밍 언어 없이도 사용자가 에이전트 도구(예: Claude Code, Antigravity 등)에 주입하여 즉시 활용할 수 있는 토큰 절약 의사코드 규칙은 다음과 같습니다:
1. 지휘관-실행원 역할 분리 선언:
- 메인 에이전트(지휘관)는 계획 수립 및 최종 검수만 담당하고 직접 긴 본문 작성을 금지함
2. 서브에이전트 위임 조건 정의:
- 각 하위 과제(자료 검색, 표 작성, 영문 번역)는 독립된 [Haiku 서브에이전트]를 생성하여 위임
- 각 서브에이전트에게는 해당 작업에 꼭 필요한 최소한의 텍스트(2,000자 이내)만 전달
3. 토큰 임계 감시 규칙:
- 만약 서브에이전트 대화 토큰이 80,000을 초과하면 즉시 핵심 결론만 요약 파일로 디스크에 저장
- 이전 대화 세션을 폐기하고 새로운 세션에서 요약 파일만을 로드하여 작업 재개
4. 최종 산출물 통합:
- 지휘관 에이전트가 각 서브에이전트의 완성본 파일 경로만을 취합하여 최종 사용자 보고서 출력
핵심 요약
자주 묻는 질문 ❓
참고 문헌 및 기술 자료
- Anthropic Engineering Blog: "Prompt Caching & Subagent Orchestration Best Practices" (2026)
- ACM Computing Surveys: "Context Inflation and Token Economics in Large Language Models"
- Haiku vs Opus Benchmark Report: "Economic Efficiency of Specialized Micro-Agent Swarms"
- KNOWLEARN AI Knowledge Lab: Enterprise LLM Cost Optimization & Subagent Architecture


