▲ 자율 AI 에이전트의 루프 폭주와 실시간 서킷 브레이커 차단 모니터링 개념도
인공지능 코딩 도구의 눈부신 발전으로 이제 누구나 간단한 프롬프트 몇 줄만으로 밤새 스스로 생각하고 판단하는 자율 에이전트(Autonomous Agent) 프로그램을 개발할 수 있는 시대가 되었습니다. 하지만 에이전트에게 온전한 자율권을 쥐어주었을 때, 단 한 줄의 조건문 실수로 인해 상상을 초월하는 API 비용 청구서를 마주할 수 있다는 사실을 체감해 보신 적이 있으신가요?
최근 글로벌 개발자 커뮤니티에서는 재미 삼아 실행해 둔 밈(Meme) 이미지 자동 생성 파이썬 스크립트가 단 8시간 만에 1,900달러(약 260만 원)의 API 요금을 태워버린 사건이 큰 충격을 주었습니다. 이 사건은 단순한 해프닝을 넘어, 자율 AI 워크플로우 설계 시 왜 서킷 브레이커(Circuit Breaker)와 토큰 가드레일이 필수 불가결한지 여실히 보여줍니다.
사건의 전말: 50개 성공할 때까지 멈추지 마라
사건의 시작은 단순한 자동화 아이디어였습니다. 한 개발자가 Claude Code에게 유머러스한 밈 캡션 50개를 생성해 이미지에 합성하는 파이썬 스크립트 작성을 요청했습니다. 개발자가 부여한 핵심 요구 조건은 "중복되지 않는 기발한 캡션 50개가 완성될 때까지 반복 생성하고 종료할 것"이었습니다.
개발자는 아침에 프로그램을 구동해두고 본업을 보러 나갔습니다. 오후 늦게 돌아와 결과를 확인했을 때, 목표치인 50개 중 단 12개만 완성되어 있었습니다. 그러나 디버그 폴더에는 수천 장의 실패 이미지가 쌓여 있었고, Anthropic API 대시보드 청구액은 무려 1,900달러에 달해 있었습니다.
비용 폭탄을 부른 4가지 치명적 결함
왜 고작 캡션 50개를 만드는 작업에서 260만 원이 청구되었을까요? 시스템 아키텍처 관점에서 네 가지 치명적 결함이 겹쳐진 연쇄 재앙이었습니다.
| 비교 구분 | 일반적인 정상 설계 | 참사를 부른 실제 구현 | 피해 결과 |
|---|---|---|---|
| 모델 선택 | 가벼운 소형 모델 (Haiku 등) | 고성능 초고가 모델 (Opus 4.6) | 토큰당 기본 단가 수십 배 폭증 |
| 종료 조건 | 최대 시도 횟수 제한 (Max 50회) | 성공 결과 개수만 확인 (While 미달성) | 조건 미달 시 무한 루프(Infinite Loop) |
| 컨텍스트 관리 | 세션 초기화 (Stateless 독립 호출) | 거절된 이전 실패 이력을 모두 누적 | 매 요청마다 수십만 토큰 전송 (컨텍스트 팽창) |
| 비용 절감 기술 | 프롬프트 캐싱 (Prompt Caching) | 캐싱 미적용 일반 반복 호출 | 3억 7,500만 토큰에 100% 원가 청구 |
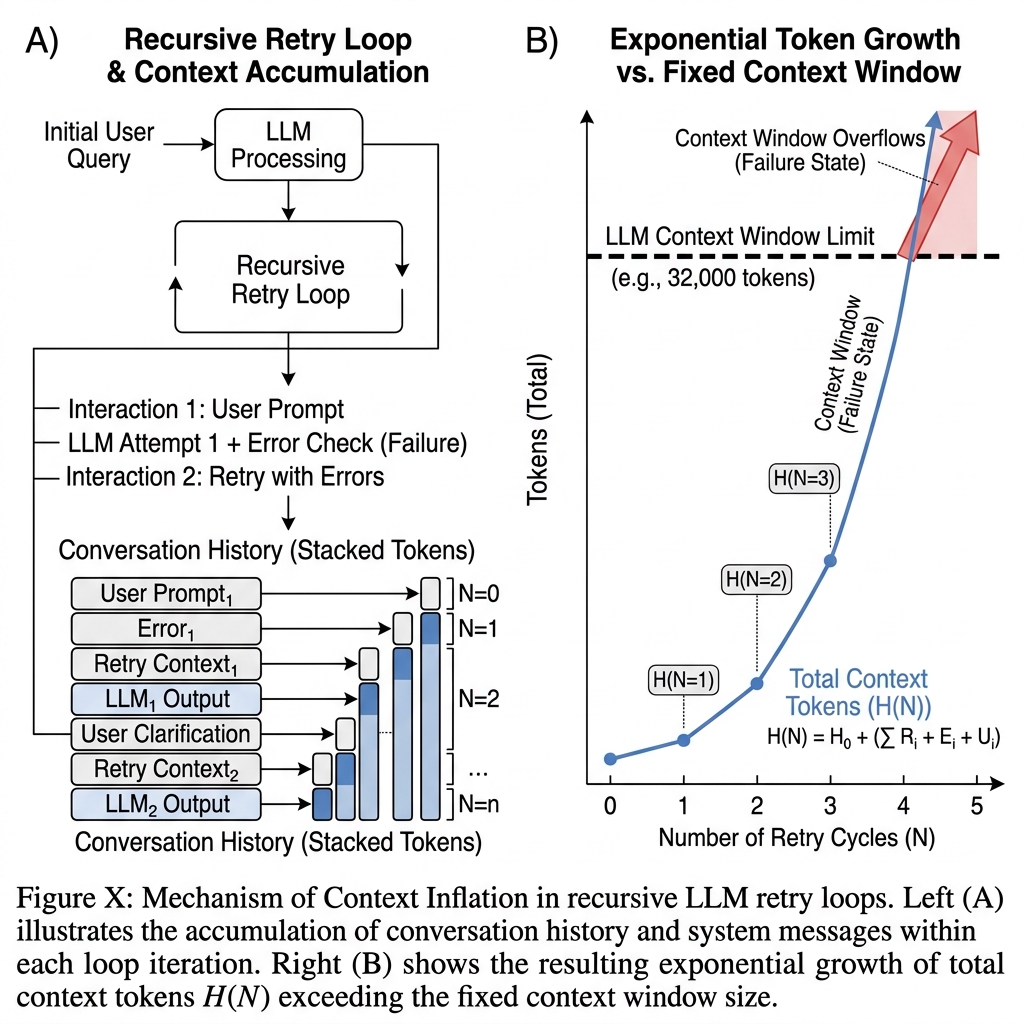
▲ 재귀적 재시도 루프에서 대화 이력이 누적되며 토큰 소비가 지수 함수로 폭증하는 구조
실생활 비유로 이해하는 컨텍스트 인플레이션
이 기현상을 실생활에 비유하면 직관적으로 이해할 수 있습니다.
식당에서 웨이터에게 메뉴 추천을 부탁하는 상황을 상상해 보세요:
- 정상적인 방식: 웨이터에게 "오늘 추천 메뉴 하나만 알려주세요"라고 짧고 명확하게 묻습니다.
- 참사를 부른 방식: 웨이터에게 "내가 지금까지 거절했던 지난 1,000가지 메뉴 목록과, 각 메뉴를 거절한 이유가 적힌 30페이지짜리 사유서를 전부 처음부터 소리 내어 읽은 뒤, 새로운 메뉴를 추천해줘"라고 매 시도마다 요구한 꼴입니다.
결과적으로 단 한 줄의 농담을 얻기 위해 매번 수십만 자의 이전 대화록을 전송했고, 8시간 동안 무려 3억 7,500만 개의 인풋 토큰이 고스란히 낭비되었습니다.
서킷 브레이커: AI 에이전트를 위한 두꺼비집
가정에 과전류가 흐르면 화재를 막기 위해 '두꺼비집(배선 차단기)'이 자동으로 내려가 전기를 차단합니다. 자율 AI 에이전트 시스템에도 똑같은 원리의 서킷 브레이커(Circuit Breaker)가 반드시 배치되어야 합니다.
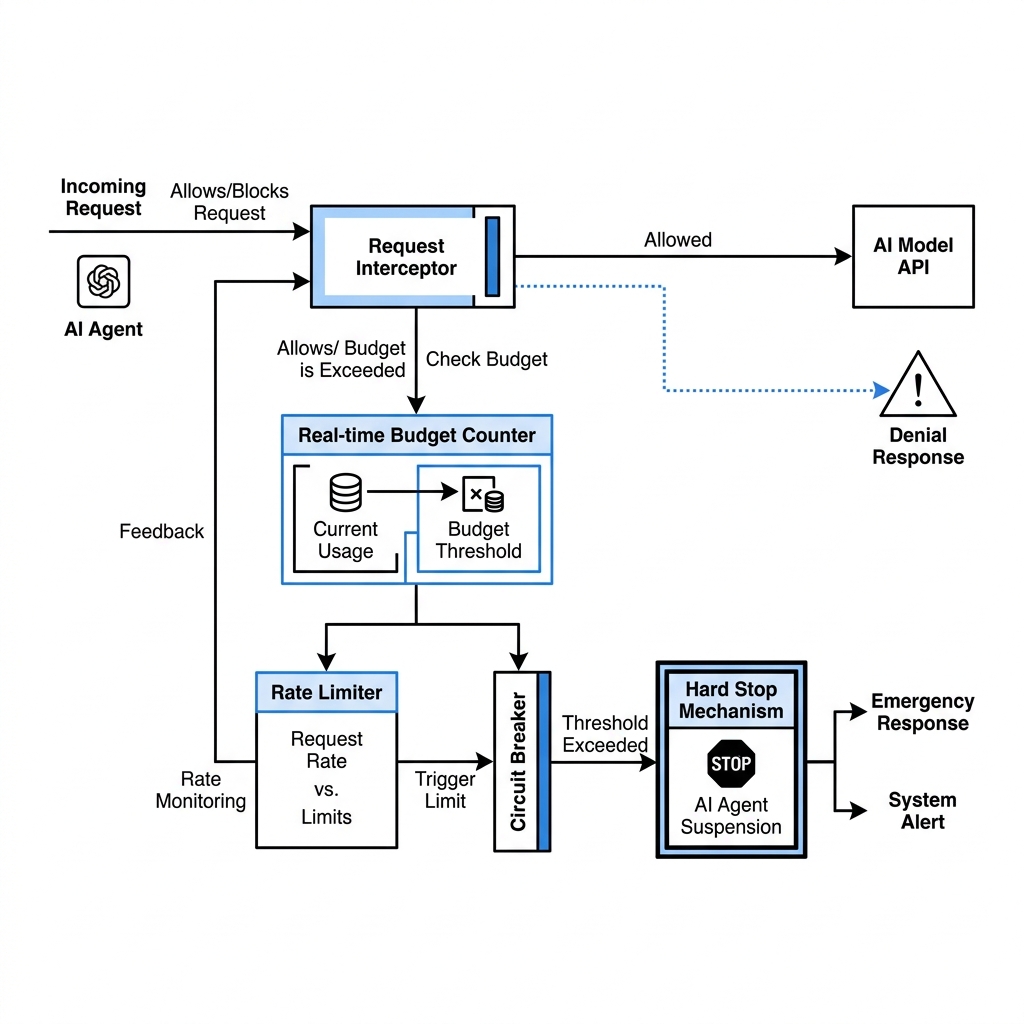
▲ 인터셉터-예산 검증기-쿨다운 차단기로 구성된 자율 AI 서킷 브레이커 3단계 파이프라인
서킷 브레이커의 3단계 방어 파이프라인
- Step 1. 요청 가로채기 및 비용 측정 (Request Interceptor): AI 모델로 날아가는 모든 요청의 문턱에서 인터셉터가 누적 비용과 남은 예산을 0.01초 단위로 실시간 계산합니다.
- Step 2. 3중 방어 가드레일 판정 (Triple Guardrail):
- 시도 횟수 캡(Attempt Cap): 성공 여부와 무관하게 총 시도가 100회를 넘으면 즉각 정지.
- 세션 예산 캡(Session Budget Cap): 할당된 예산(예: 5달러)을 1센트라도 넘기면 전원 차단.
- 시간 타임아웃(Timeout): 사람이 자리를 비운 사이 혼자 폭주하지 않도록 최대 실행 시간 강제.
- Step 3. 비상 차단 및 관리자 경보 (Hard Stop & Alert): 임계값을 벗어나는 순간 즉시 프로세스를 강제 종료(Kill)하고 슬랙이나 스마트폰으로 경보를 발송합니다.
비개발자도 이해하는 안전한 에이전트 작동 원리
프로그래밍 코드를 전혀 몰라도 아래의 한글 의사코드 흐름만 숙지하면 내 에이전트가 안전한지 한눈에 점검할 수 있습니다.
1. 초기 안전 기준 설정:
- 최대 허용 비용 = 5,000원
- 최대 시도 횟수 = 50회
- 현재 누적 비용 = 0원 / 현재 시도 횟수 = 0회
2. 반복 작업 진행 (매 시도마다 서킷 브레이커 검사):
- 만약 (현재 시도 횟수 >= 50회) 라면:
-> "최대 시도 횟수 초과" 알림 후 즉시 안전 중단!
- 만약 (현재 누적 비용 >= 5,000원) 이라면:
-> "예산 초과! 서킷 브레이커 작동" 경보 후 전원 차단!
3. AI에게 새 캡션 요청:
- 이전 실패 이력을 길게 쌓지 않고, 핵심 지침만 전달 (컨텍스트 초기화)
- 사용된 토큰 비용을 계산하여 [현재 누적 비용]에 합산
- [현재 시도 횟수]를 1 증가
4. 결과 검사 및 안전 종료:
- 조건에 맞으면 수집함에 저장
- 수집함에 50개가 차면 "작업 성공 완료" 후 정상 종료
프롬프트 캐싱: 10분의 1로 비용을 묶는 마지막 방패
반복적으로 동일한 시스템 지침이나 배경 지식을 AI에게 주입해야 한다면 프롬프트 캐싱(Prompt Caching)은 선택이 아닌 필수입니다.
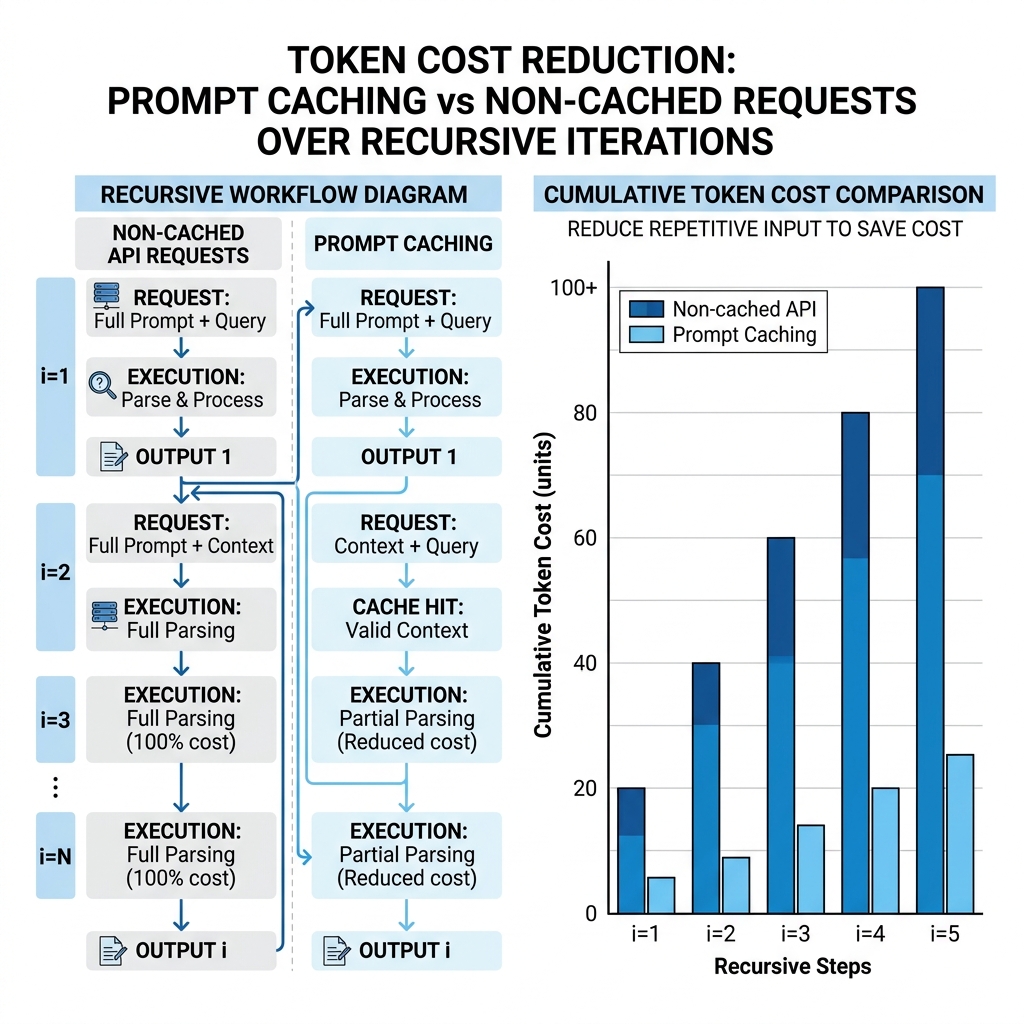
▲ 프롬프트 캐싱 미적용 시 1,900달러에 달하는 비용이 캐싱 적용 시 180달러대로 급감하는 비교
도서관에서 책을 빌릴 때마다 처음부터 끝까지 정독하는 것(비캐싱)과, 이미 읽어둔 페이지에 책갈피를 꽂아두고 필요한 부분만 0.1초 만에 확인하는 것(캐싱)의 차이입니다. 주요 LLM의 캐싱 기능을 활용하면 반복되는 인풋 토큰 비용을 최대 90%까지 즉각 절감할 수 있습니다.
핵심 요약
자주 묻는 질문 ❓
참고 문헌 및 기술 자료
- Anthropic Claude API Documentation: Prompt Caching & Token Management Guidelines (2026)
- Reddit r/ClaudeAI Community Case Study: "I accidentally made a $1,900 meme" by @roy69al (2026)
- Martin Fowler: Software Architecture Patterns - "Circuit Breaker Pattern"
- OpenAI & Anthropic Rate Limits, Tier Architecture & Hard Spending Cap Best Practices (2026)
'AI 트랜드' 카테고리의 다른 글
| 토큰 비용 98% 절감의 비밀: 초경량 서브에이전트 위임 설계와 실전 AI 라이프핵(Lifehack) (0) | 2026.10.16 |
|---|---|
| 클로드 프로젝트(Projects)의 대변혁: 단순 폴더에서 '자율 에이전트 협업 대시보드'로의 전환과 실무 대응법 (0) | 2026.10.16 |
| AI 모델 성능 저하 논란의 진실: LiveNerf 20일 데이터로 본 Opus 추적과 LLM 스로틀링 메커니즘 (0) | 2026.10.16 |
| 일반 가정용 PC에서 Claude Sonnet급 AI를 로컬 구동하는 날이 온다면: 양자화 혁명과 하드웨어 병목 돌파구 (0) | 2026.10.15 |
| 양산형 SaaS 복제는 그만: AI 바이브 코딩 시대가 열어젖힐 공공재 소프트웨어와 부채 상계 혁신 (0) | 2026.10.14 |


